O gradiente de um algoritmo é o gradiente da solução?
Duas funções sob a mesma notação
Na minha dissertação ainda em desenvolvimento, o gradiente atravessa um número fixo de passos do solver durante o treinamento; já na inferência, o solver usa critérios de parada. Essa diferença me fez pensar:
O que estamos aprendendo quando diferenciamos um processo de otimização interrompido?
Uma camada de uma rede pode ser definida por um problema de otimização. A entrada determina uma função de custo, e a solução desse problema segue para o restante do modelo. Na implementação, esse cálculo costuma aparecer como um laço de atualizações do solver. Podemos então retropropagar o gradiente da perda através dessas atualizações para treinar o modelo.
O algoritmo, porém, devolve o resultado de um número finito de passos. É essa computação que a diferenciação automática deriva. Para que o gradiente obtido coincida com o da solução do problema, precisamos de condições adicionais. A diferença pode ser grande o suficiente para que os dois gradientes tenham sinais opostos.
Quero acompanhar essa diferença desde a regra da cadeia até um exemplo que caiba em poucas linhas de código — não será necessário recorrer a uma rede profunda: uma quadrática estritamente convexa, com duas variáveis e solução explícita, já permite separar os efeitos.
Sejam \(z\in\mathbb{R}^d\) a variável interna e \(\theta\in\mathbb{R}^p\) os parâmetros que queremos aprender. Escrevo a solução do problema interno como
\[ z^\star(\theta)=\operatorname*{arg\,min}_{z} f(z,\theta). \]
Uma perda externa \(\ell\) avalia essa solução. Por exemplo, \(f\) pode combinar fidelidade aos dados e regularização, enquanto \(\ell\) mede o erro de uma predição produzida a partir de \(z\). A função que gostaríamos de minimizar seria
\[ L_\star(\theta)=\ell(z^\star(\theta),\theta). \]
Por enquanto, suponho que o mínimo seja único e que as derivadas usadas abaixo existam. Mais adiante será preciso tornar essas hipóteses mais precisas.
Na implementação, escolhemos uma inicialização \(z_0(\theta)\), uma atualização \(T\) e um orçamento \(K\):
\[ z_{k+1}(\theta)=T(z_k(\theta),\theta), \qquad L_K(\theta)=\ell(z_K(\theta),\theta). \]
A composição de \(K\) atualizações define outra função dos parâmetros. Inicialização, tamanho de passo e número de iterações fazem parte dessa definição. Se todas as dependências forem preservadas no grafo, a diferenciação automática calcula \(\nabla_\theta L_K\), com os erros numéricos da aritmética empregada.1
Treinar essa composição pode ser uma escolha deliberada. Domke estuda justamente modelos cujo treinamento considera a saída de uma otimização truncada em um número fixo de iterações.2 Para uma aplicação que também executará apenas esses passos, \(L_K\) pode ser o objetivo que interessa. A questão surge quando se escreve \(L_\star\) na formulação e se interpreta o gradiente de \(L_K\) como se a substituição fosse inofensiva.
Diferenciando os passos
A sensibilidade também obedece a uma recorrência
Defina a matriz de sensibilidades
\[ J_k=\frac{\partial z_k}{\partial\theta} \in\mathbb{R}^{d\times p}. \]
Aplicar a regra da cadeia à atualização fornece
\[ J_{k+1} = D_zT(z_k,\theta)J_k + D_\theta T(z_k,\theta). \]
O primeiro termo transporta a dependência acumulada nos passos anteriores. O segundo registra a dependência direta da atualização atual em \(\theta\). Para uma inicialização constante, \(J_0=0\). Se a inicialização for a saída de outra rede, sua derivada precisa entrar como \(J_0\).
Depois de \(K\) passos, a derivada da perda é
\[ \nabla_\theta L_K = \nabla_\theta\ell(z_K,\theta) + J_K^\top\nabla_z\ell(z_K,\theta), \]
em que o primeiro termo é uma derivada parcial: \(z_K\) fica fixo ao calculá-lo. Essa expressão deixa visível o que a diferenciação automática precisa propagar.
Construir \(J_k\) explicitamente é conveniente para a derivação e para exemplos com poucos parâmetros. Quando \(\theta\) tem milhões de componentes e a perda é escalar, o modo reverso calcula os produtos necessários sem materializar essa matriz inteira. Os dois modos aplicam a mesma regra da cadeia à mesma função. Franceschi e colaboradores desenvolvem essas duas formas de propagar derivadas através de algoritmos de aprendizado iterativos, com diferentes custos de tempo e memória.3
O caso da descida de gradiente
Considere um passo fixo \(\eta\), independente de \(\theta\):
\[ z_{k+1}=z_k-\eta\nabla_z f(z_k,\theta). \]
Com
\[ H_k=\nabla^2_{zz}f(z_k,\theta), \qquad B_k=(D_\theta\nabla_z f)(z_k,\theta), \]
em que a derivada parcial que define \(B_k\) mantém \(z\) fixo e é então avaliada em \((z_k,\theta)\), obtemos
\[ J_{k+1}=(I-\eta H_k)J_k-\eta B_k. \]
Portanto, derivar através de uma atualização que já usa um gradiente introduz derivadas de segunda ordem. Não é preciso montar uma Hessiana densa para isso: produtos Hessiana-vetor podem bastar, como mostra a construção de Pearlmutter para calculá-los sem armazenar a matriz completa.4 Mas eliminar essas dependências do grafo altera a derivada calculada.
Também é preciso distinguir duas formas de truncamento. Executar \(K\) passos e diferenciar todos eles produz \(\nabla_\theta L_K\). Executar muitos passos, cortar o histórico com detach e retropropagar apenas pelos últimos passos trata o estado no corte como constante. Nesse segundo caso, a derivada da computação original foi modificada. Shaban e colaboradores estudam os gradientes aproximados produzidos por esse truncamento e dão condições suficientes para a convergência da otimização externa.5
Diferenciando a solução
A condição de otimalidade
Para um problema sem restrições, uma solução interior satisfaz
\[ \nabla_z f(z^\star(\theta),\theta)=0. \]
Suponha que \(f\) seja duas vezes continuamente diferenciável numa vizinhança da solução e que
\[ H_\star=\nabla^2_{zz}f(z^\star,\theta) \]
seja invertível. O teorema da função implícita permite acompanhar localmente esse ponto estacionário como uma função diferenciável de \(\theta\). Uma Hessiana positiva definida garante que o ramo acompanhado continua sendo de mínimos locais; forte convexidade global, quando presente, também garante a unicidade do mínimo. Em problemas não convexos, a análise é local e não resolve possíveis trocas entre mínimos.
Diferenciando a condição de otimalidade,
\[ H_\star J_\star+B_\star=0, \qquad J_\star=-H_\star^{-1}B_\star, \]
onde \(J_\star=\partial z^\star/\partial\theta\) e \(B_\star=(D_\theta\nabla_z f)(z^\star,\theta)\).
A atualização do otimizador desapareceu da expressão. A derivada depende da geometria do problema no mínimo escolhido. Dois algoritmos que encontram a mesma solução regular levam à mesma sensibilidade implícita, mesmo que tenham seguido trajetórias diferentes. Blondel e colaboradores exploram essa separação entre o algoritmo de solução e a equação que define sua derivada.6
O sistema adjunto
Substituindo \(J_\star\) na regra da cadeia,
\[ \nabla_\theta L_\star = \nabla_\theta\ell(z^\star,\theta) - B_\star^\top H_\star^{-\top}\nabla_z\ell(z^\star,\theta). \]
A inversa ajuda a ler a fórmula, mas não é uma instrução para calculá-la. Basta resolver
\[ H_\star^\top v=\nabla_z\ell(z^\star,\theta) \]
e então usar
\[ \nabla_\theta L_\star = \nabla_\theta\ell(z^\star,\theta)-B_\star^\top v. \]
Esse é o sistema adjunto. Ele evita construir um Jacobiano \(d\times p\) quando precisamos apenas da derivada de uma perda escalar.
Há uma tentação de eliminar toda essa conta dizendo que o gradiente interno é zero no mínimo. Esse argumento se aplica, por exemplo, quando a função externa é o próprio valor ótimo de \(f\). De fato,
\[ \nabla_\theta\bigl[f(z^\star(\theta),\theta)\bigr] = \nabla_\theta f(z^\star,\theta) + J_\star^\top \underbrace{\nabla_z f(z^\star,\theta)}_{0}. \]
Essa identidade é o caso suave e sem restrições do argumento de envelope. Para uma perda externa diferente, \(\nabla_z\ell(z^\star,\theta)\) em geral não é zero. O fato de \(z^\star\) minimizar \(f\) não autoriza ignorar como ele varia dentro de \(\ell\).
Quando as derivadas se aproximam
As duas construções se encontram quando a atualização converge para a solução e sua sensibilidade também converge. Se \(z^\star=T(z^\star,\theta)\), a diferenciação dessa equação dá
\[ \bigl(I-D_zT(z^\star,\theta)\bigr)J_\star = D_\theta T(z^\star,\theta). \]
A mesma conta aparece nos modelos de equilíbrio profundo de Bai, Kolter e Koltun: o estado é definido como um ponto fixo, encontrado por um solucionador de raízes, e a retropropagação usa diferenciação implícita.7 A equação de equilíbrio pode definir a camada mesmo quando a atualização não corresponde a um passo de minimização.
Quando o raio espectral de \(D_zT(z^\star,\theta)\) é menor que um, a inversa pode ser escrita como uma série de Neumann:
\[ J_\star = \sum_{i=0}^{\infty} \bigl[D_zT(z^\star,\theta)\bigr]^i D_\theta T(z^\star,\theta). \]
Essa série usa os Jacobianos avaliados no ponto fixo. Em uma trajetória não linear, os Jacobianos mudam a cada passo; o desenrolamento finito não é, em geral, apenas o corte dessa mesma série.
Usarei a norma euclidiana para vetores e a norma de operador correspondente para matrizes. Uma condição suficiente mais forte, e útil para entender a convergência, é que \(T\) seja uma contração uniforme numa região que contenha a trajetória e o ponto fixo, para parâmetros numa vizinhança do ponto estudado, com fator \(0 \lt q \lt 1\). Suponha ainda que \(T\) seja continuamente diferenciável e que suas derivadas parciais sejam Lipschitz em \(z\) nessa região. Fixando \(\theta\), a recorrência de sensibilidades permite limitar o erro por
\[ \|J_{k+1}-J_\star\| \leq q\|J_k-J_\star\|+c\|z_k-z^\star\|, \]
para uma constante \(c\) que depende dessas derivadas e de \(J_\star\). Como a contração também fornece \(\|z_k-z^\star\|\leq Dq^k\), com \(D=\|z_0-z^\star\|\), segue que
\[ \|J_K-J_\star\| \leq q^K\|J_0-J_\star\| + cD Kq^{K-1}. \]
Os dois termos tendem a zero. Com continuidade das derivadas da perda externa, também obtemos \(\nabla_\theta L_K\to\nabla_\theta L_\star\). Grazzi e colaboradores apresentam limites quantitativos para esses erros sob hipóteses de contração e regularidade.8
A presença dessas hipóteses importa. Convergência dos valores de uma sequência de funções, isoladamente, não permite passar a derivada pelo limite. E, mesmo no regime em que tudo converge, um \(q\) próximo de um pode exigir muitos passos para uma boa aproximação da sensibilidade.
Uma quadrática com duas escalas
Solução e trajetória em forma fechada
Considere agora um parâmetro escalar \(\theta\) e o problema
\[ f(z,\theta)=\frac12z^\top Az-\theta b^\top z, \qquad A= \begin{pmatrix} 1&0\\ 0&0{,}01 \end{pmatrix}, \qquad b= \begin{pmatrix} 1\\ 0{,}01 \end{pmatrix}. \]
Como \(A\) é positiva definida, o mínimo é único:
\[ Az^\star=\theta b \quad\Longrightarrow\quad z^\star(\theta)=\theta A^{-1}b = \begin{pmatrix} \theta\\ \theta \end{pmatrix}. \]
Escolho a perda externa
\[ \ell(z)=\frac12\|z-y\|_2^2, \qquad y= \begin{pmatrix} 0\\ 3 \end{pmatrix}. \]
Logo,
\[ L_\star(\theta)=\frac12\bigl[\theta^2+(\theta-3)^2\bigr], \qquad g_\star(\theta)=\frac{dL_\star}{d\theta}=2\theta-3. \]
No ponto \(\theta=1\), a derivada é \(g_\star=-1\). Um pequeno aumento de \(\theta\) reduz a perda externa avaliada na solução.
A descida de gradiente, por sua vez, segue
\[ z_{k+1}=(I-\eta A)z_k+\eta\theta b. \]
Defina \(M=I-\eta A\). Para uma inicialização constante, a soma da progressão matricial fornece
\[ z_K=M^Kz_0+\theta(I-M^K)A^{-1}b, \]
e, portanto,
\[ J_K=(I-M^K)A^{-1}b, \qquad J_\star=A^{-1}b. \]
Aqui a ligação entre desenrolamento e série de Neumann é exata:
\[ J_K=\eta\sum_{i=0}^{K-1}M^i b. \]
Para \(0<\eta<2/\lambda_{\max}(A)\), todos os autovalores de \(M\) têm módulo menor que um. Assim, \(M^K\to0\) e \(J_K\to J_\star\). Em uma direção de curvatura \(\lambda\), a sensibilidade é multiplicada pelo fator
\[ 1-(1-\eta\lambda)^K. \]
A direção de pequena curvatura pode levar bastante tempo para adquirir sua sensibilidade completa.
Um gradiente com o sinal oposto
Use \(\eta=1\), \(z_0=(0,0)^\top\) e avalie em \(\theta=1\). Para \(K\geq1\), escrevendo \(q_K=0{,}99^K\),
\[ z_K= \begin{pmatrix} 1\\ 1-q_K \end{pmatrix}, \qquad J_K= \begin{pmatrix} 1\\ 1-q_K \end{pmatrix}. \]
O gradiente desenrolado é
\[ \begin{aligned} g_K &=(z_K-y)^\top J_K\\ &=1+(-2-q_K)(1-q_K)\\ &=-1+q_K+q_K^2. \end{aligned} \]
Já a distância até a solução e a diferença de objetivo interno são
\[ \|z_K-z^\star\|_2=q_K, \qquad f(z_K,1)-f(z^\star,1)=0{,}005q_K^2. \]
Após 40 passos, \(q_K\approx0{,}6690\). A diferença de objetivo interno é cerca de \(0{,}00224\), mas o erro na solução ainda é \(0{,}6690\). A baixa curvatura na segunda coordenada torna esse erro relativamente barato para \(f\). Não há motivo para que ele também seja barato para \(\ell\).
Nesse ponto,
\[ g_{40}\approx+0{,}1165, \qquad g_\star=-1. \]
Uma atualização externa \(\theta\leftarrow\theta-\alpha g_{40}\), com \(\alpha>0\) pequeno, reduz \(\theta\). Ela é uma direção de descida para \(L_{40}\), mas de subida para \(L_\star\) naquele ponto. A diferenciação está correta para a função que foi executada.
E se o algoritmo já devolver a solução exata?
Vale fazer uma alteração no exemplo. Fixe agora a inicialização em \(z_0=(1,1)^\top\), mantendo esse mesmo vetor para todos os valores de \(\theta\). No ponto de avaliação \(\theta=1\), a inicialização coincide com o mínimo, e as atualizações não movem o estado:
\[ z_K(1)=z^\star(1) \qquad\text{para todo }K. \]
Mesmo assim, como a inicialização é constante, \(J_0=0\). A sensibilidade após \(K\geq1\) passos continua sendo \((1,1-q_K)^\top\). Agora,
\[ g_K=(1,-2) \begin{pmatrix} 1\\ 1-q_K \end{pmatrix} =-1+2q_K. \]
Para \(K=40\), isso resulta em \(g_K\approx+0{,}3379\). O estado está exatamente no mínimo, o resíduo de otimalidade é zero e a derivada ainda tem sinal oposto a \(g_\star\).
O exemplo foi construído para coincidir em um ponto. Ao perturbar \(\theta\), o vetor inicial permanece em \((1,1)^\top\), enquanto a solução muda para \((\theta,\theta)^\top\). As duas funções se encontram em \(\theta=1\), mas têm tangentes diferentes.
Se tivéssemos definido uma inicialização diferenciável \(z_0(\theta)=(\theta,\theta)^\top\), então \(J_0=(1,1)^\top\) e a derivada já seria a correta desde o início. Essa distinção também aparece ao reutilizar uma solução anterior como warm start: mantê-la constante na diferenciação é uma escolha sobre a dependência que o programa vai representar.
Implementação do exemplo
O código em NumPy calcula a trajetória, propaga sua sensibilidade e compara as derivadas com diferenças finitas.
Derivadas e diferenças finitas
A função executar propaga a sensibilidade em modo direto. Ela escreve explicitamente a regra da cadeia, o que permite acompanhar a dependência da inicialização e do número de passos. A diferença central avalia a mesma computação em dois valores próximos do parâmetro.
from collections.abc import Callable

import numpy as np

a = np.array([1.0, 0.01], dtype=np.float64)  # diagonal de A
b = np.array([1.0, 0.01], dtype=np.float64)
y = np.array([0.0, 3.0], dtype=np.float64)


def executar(
    theta: float, k: int, z0: np.ndarray, eta: float = 1.0
) -> tuple[np.ndarray, np.ndarray]:
    """Retorna z_K e dz_K/dtheta, mantendo z0 constante."""
    z = np.array(z0, dtype=np.float64, copy=True)
    j = np.zeros_like(z)
    for _ in range(k):
        z = z - eta * (a * z - theta * b)
        j = (1.0 - eta * a) * j + eta * b
    return z, j


def perda(z: np.ndarray) -> float:
    """Perda externa quadrática."""
    return float(0.5 * np.dot(z - y, z - y))


def diferenca_central(
    funcao: Callable[[float], float], theta: float, h: float
) -> float:
    return (funcao(theta + h) - funcao(theta - h)) / (2.0 * h)


theta, k, h = 1.0, 40, 1e-5
for z0 in (np.zeros(2), np.ones(2)):
    z, j = executar(theta, k, z0)
    g = float((z - y) @ j)
    fd = diferenca_central(
        lambda t: perda(executar(t, k, z0)[0]), theta, h
    )
    print(f"z0={z0}: cadeia={g:+.9f}; diferenças finitas={fd:+.9f}")

z_estrela = np.linalg.solve(np.diag(a), theta * b)
v = np.linalg.solve(np.diag(a).T, z_estrela - y)
g_estrela = float(b @ v)  # B = -b; logo -B^T v = b^T v
fd_estrela = diferenca_central(lambda t: perda(t * b / a), theta, h)
print(f"implícita={g_estrela:+.9f}; diferenças finitas={fd_estrela:+.9f}")

# z0=[0. 0.]: cadeia=+0.116494972; diferenças finitas=+0.116494972
# z0=[1. 1.]: cadeia=+0.337943517; diferenças finitas=+0.337943517
# implícita=-1.000000000; diferenças finitas=-1.000000000
Variando o número de passos
A mesma função permite comparar as duas inicializações para diferentes números de passos. O bloco abaixo calcula os gradientes e, para o início em zero, a distância até a solução e a diferença de objetivo interno.
print("   K      erro_z     gap interno    g_K (zero)   g_K (constante)")
for k in (1, 10, 40, 100, 400, 1000):
    z, j = executar(1.0, k, np.zeros(2))
    z_const, j_const = executar(1.0, k, np.ones(2))
    erro = z - b / a
    # A identidade da quadrática evita subtrair objetivos quase iguais.
    gap = float(0.5 * np.dot(a * erro, erro))
    g = float((z - y) @ j)
    g_const = float((z_const - y) @ j_const)
    print(
        f"{k:4d}   {np.linalg.norm(erro):.6f}   {gap:.3e}"
        f"      {g:+.6f}     {g_const:+.6f}"
    )
A tabela mostra os resultados arredondados. As colunas de erro e de diferença de objetivo correspondem à inicialização em zero.
| \(K\) | Erro na solução | Diferença de objetivo interno | \(g_K\), início em \((0,0)\) | \(g_K\), início constante em \((1,1)\) |
|---|---|---|---|---|
| 1 | 0,990000 | \(4{,}901\times10^{-3}\) | +0,970100 | +0,980000 |
| 10 | 0,904382 | \(4{,}090\times10^{-3}\) | +0,722289 | +0,808764 |
| 40 | 0,668972 | \(2{,}238\times10^{-3}\) | +0,116495 | +0,337944 |
| 100 | 0,366032 | \(6{,}699\times10^{-4}\) | −0,499988 | −0,267935 |
| 400 | 0,017951 | \(1{,}611\times10^{-6}\) | −0,981727 | −0,964099 |
| 1000 | 0,000043 | \(9{,}319\times10^{-12}\) | −0,999957 | −0,999914 |
Em todas as linhas, \(g_\star=-1\). Para a inicialização constante em \((1,1)\), o erro na solução e a diferença de objetivo são zero no ponto avaliado.
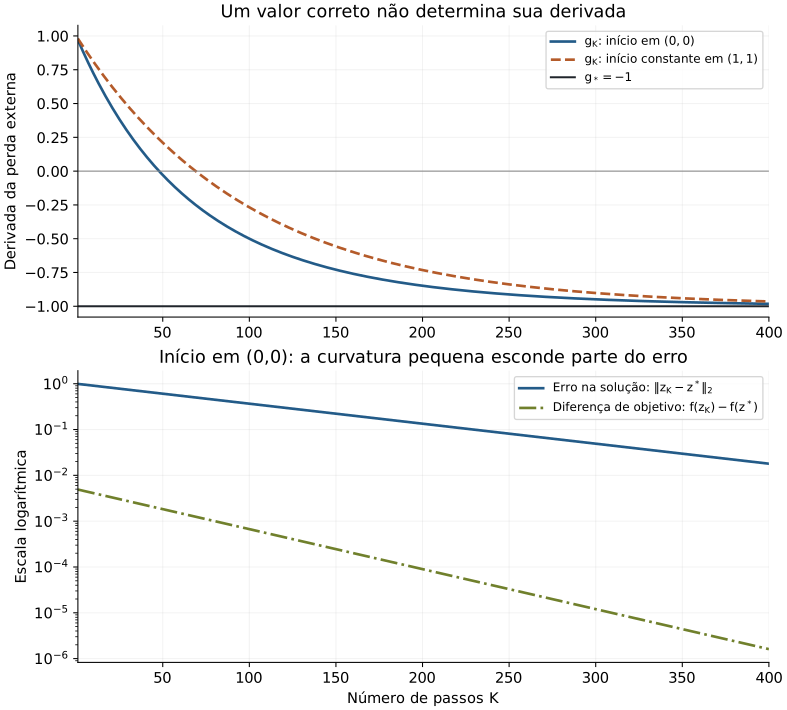
Acima, derivadas da perda externa para θ = η = 1, comparadas à derivada da solução. Abaixo, erro de estado e diferença de objetivo interno para a inicialização em zero, em escala logarítmica. Valores calculados pelas recorrências do exemplo.
O que as diferenças finitas verificam
A diferença central
\[ \frac{L_K(\theta+h)-L_K(\theta-h)}{2h} \]
testa o gradiente de \(L_K\). É necessário manter o mesmo \(K\), o mesmo passo e a mesma inicialização constante nas duas avaliações. No caso iniciado em \((1,1)^\top\), recalcular a inicialização como \((\theta+h,\theta+h)^\top\) e \((\theta-h,\theta-h)^\top\) mudaria a função sob teste.
Para verificar \(g_\star\), avaliamos as soluções dos problemas perturbados:
\[ \frac{L_\star(\theta+h)-L_\star(\theta-h)}{2h}. \]
No exemplo, essas soluções são conhecidas em forma fechada. Em problemas sem essa conveniência, a tolerância do solucionador precisa ser suficientemente apertada para que o erro das avaliações não domine a divisão por \(h\).
Tolerância do estado e tolerância da derivada
Na diferenciação implícita numérica, há duas aproximações a controlar: a solução do problema interno e a solução do sistema adjunto.
Para um objetivo diferenciável e \(\mu\)-fortemente convexo, o resíduo de estacionariedade limita o erro de estado:
\[ \|\widehat z-z^\star\| \leq \frac{\|\nabla_z f(\widehat z,\theta)\|}{\mu}. \]
Esse resultado vem da monotonicidade forte do gradiente,
\[ \bigl\langle \nabla_z f(\widehat z,\theta)-\nabla_z f(z^\star,\theta), \widehat z-z^\star \bigr\rangle \geq \mu\|\widehat z-z^\star\|^2, \]
combinada com Cauchy–Schwarz e \(\nabla_z f(z^\star,\theta)=0\). Um resíduo pequeno precisa ser interpretado à luz da curvatura mínima \(\mu\).
Mesmo que \(z^\star\) seja exato, o sistema adjunto pode ser resolvido apenas aproximadamente. Se \(\widehat v\) tem resíduo
\[ r_v=H_\star^\top\widehat v-\nabla_z\ell(z^\star,\theta), \]
então
\[ \widehat v-v=H_\star^{-\top}r_v. \]
Para \(\widehat g=\nabla_\theta\ell-B_\star^\top\widehat v\), calculado nesse mesmo ponto exato,
\[ \|\widehat g-\nabla_\theta L_\star\| \leq \|B_\star\|\,\|H_\star^{-\top}\|\,\|r_v\|. \]
A norma da inversa pode amplificar o resíduo. Se também substituirmos \(z^\star\) por \(\widehat z\), aparece um erro adicional porque Hessiana, derivadas mistas e gradiente da perda são avaliados em outro ponto. Controlá-lo exige hipóteses de regularidade e condicionamento. Blondel e colaboradores tratam explicitamente do erro no Jacobiano quando a solução interna é aproximada.6
O controle desses erros também afeta a otimização externa. Pedregosa analisa a atualização de hiperparâmetros com gradientes inexatos e estabelece condições de convergência que incluem regularidade das funções e somabilidade dos erros.9 Assim, a precisão exigida em cada resolução interna pode fazer parte do próprio método de otimização.
Esses resíduos não certificam o gradiente desenrolado: o exemplo com inicialização em \((1,1)\) já mostrou resíduo interno zero e sensibilidade incompleta. Eles têm outro papel, ligado à aproximação das equações que definem o gradiente implícito.
Há ainda uma diferença entre um laço com \(K\) fixo e um laço que para ao atingir uma tolerância. No segundo, o número de passos pode mudar com \(\theta\). Em uma região onde as decisões de parada não mudam, a diferenciação do caminho executado pode ser válida. Nas transições entre caminhos, a função implementada pode deixar de ser diferenciável. Perturbações por diferenças finitas também podem atravessar essas transições.
Quando há restrições
A condição \(\nabla_z f=0\) precisa ser substituída pelas condições apropriadas ao problema. O OptNet é uma referência para construir camadas de otimização quadrática e obter suas derivadas a partir das condições de Karush–Kuhn–Tucker, ou KKT.10
Um caso útil é escolher pesos que somam um. Agora \(w,\theta\in\mathbb{R}^d\). Considere uma matriz fixa \(Q\succeq0\), um escalar fixo \(\tau>0\) e
\[ w^\star(\theta) = \operatorname*{arg\,min}_{w\in\Delta} \left\{ \frac12w^\top Qw-\theta^\top w +\tau\sum_i w_i\log w_i \right\}, \qquad \Delta=\{w\geq0:\mathbf1^\top w=1\}, \]
com a extensão contínua \(0\log0=0\). Para parâmetros finitos, o termo entrópico garante um mínimo único no interior relativo do simplex. Nesse ponto, as condições são
\[ Qw-\theta+\tau(\log w+\mathbf1)+\lambda\mathbf1=0, \qquad \mathbf1^\top w=1. \]
O logaritmo atua componente a componente, e \(\lambda\) é o multiplicador da restrição de soma. Definindo
\[ H=Q+\tau\operatorname{diag}(1/w_i), \]
a diferenciação produz
\[ \begin{pmatrix} H&\mathbf1\\ \mathbf1^\top&0 \end{pmatrix} \begin{pmatrix} dw\\ d\lambda \end{pmatrix} = \begin{pmatrix} d\theta\\ 0 \end{pmatrix}. \]
A segunda linha impõe \(\mathbf1^\top dw=0\): as sensibilidades permanecem no espaço tangente ao simplex. Resolver apenas um sistema com \(H\) ignoraria essa restrição. Nesse exemplo, \(H\) é positiva definida e a restrição de igualdade tem posto completo, o que torna o sistema em blocos invertível.
O cuidado aumenta quando restrições de desigualdade passam a ficar ativas ou inativas. Mesmo um objetivo fortemente convexo pode definir uma solução não diferenciável:
\[ \operatorname*{arg\,min}_{z\geq0}\frac12(z-\theta)^2 = \max(0,\theta). \]
O mínimo é único para todo \(\theta\), mas sua derivada não existe em zero. Unicidade da solução, portanto, não basta para aplicar uma fórmula suave através de qualquer mudança de conjunto ativo.
Qual função será usada depois do treinamento?
Para uma camada que executará exatamente \(K\) passos, considero natural começar por \(L_K\). O orçamento faz parte do modelo, e o treinamento pode aprender a tirar proveito dele. Aumentar o número de passos depois muda a função avaliada; melhorar o objetivo interno não garante melhorar a perda externa. Essa possibilidade é uma das razões para tratar a otimização truncada como uma definição explícita do modelo.2
Quando o que interessa é a solução do problema, a diferenciação implícita permite que a escolha do solucionador seja feita por critérios numéricos. Em troca, é preciso resolver o problema interno com precisão adequada e verificar o sistema adjunto. Na implementação usual, o modo reverso através de \(K\) passos guarda estados intermediários; checkpointing troca parte dessa memória por recomputação. O método implícito dispensa armazenar essa trajetória para o cálculo da derivada, mas acrescenta um sistema linear cujo custo depende do condicionamento e dos produtos que conseguimos calcular.8 Não há uma vantagem de tempo universal.
O diagnóstico que eu faria antes de comparar métodos começa pela função externa: escrever \(L_K\) ou \(L_\star\), fixar a regra de inicialização e verificar cada derivada contra perturbações dessa mesma função. Depois, variaria o orçamento e as tolerâncias para observar separadamente o erro de estado e o erro de gradiente. No exemplo, bastou manter essa separação para entender por que três números corretos, \(+0{,}1165\), \(+0{,}3379\) e \(-1\), descrevem comportamentos tão diferentes.
Referências
-
BAYDIN, A. G.; PEARLMUTTER, B. A.; RADUL, A. A.; SISKIND, J. M. Automatic differentiation in machine learning: a survey. Journal of Machine Learning Research, v. 18, n. 153, p. 1–43, 2018. ↩
-
DOMKE, J. Generic methods for optimization-based modeling. In: Proceedings of the Fifteenth International Conference on Artificial Intelligence and Statistics. PMLR, v. 22, p. 318–326, 2012. ↩ ↩2
-
FRANCESCHI, L.; DONINI, M.; FRASCONI, P.; PONTIL, M. Forward and reverse gradient-based hyperparameter optimization. In: Proceedings of the 34th International Conference on Machine Learning. PMLR, v. 70, p. 1165–1173, 2017. ↩
-
PEARLMUTTER, B. A. Fast exact multiplication by the Hessian. Neural Computation, v. 6, n. 1, p. 147–160, 1994. ↩
-
SHABAN, A.; CHENG, C.-A.; HATCH, N.; BOOTS, B. Truncated back-propagation for bilevel optimization. In: Proceedings of the Twenty-Second International Conference on Artificial Intelligence and Statistics. PMLR, v. 89, p. 1723–1732, 2019. ↩
-
BLONDEL, M.; BERTHET, Q.; CUTURI, M.; FROSTIG, R.; HOYER, S.; LLINARES-LÓPEZ, F.; PEDREGOSA, F.; VERT, J.-P. Efficient and modular implicit differentiation. In: Advances in Neural Information Processing Systems, v. 35, 2022. ↩ ↩2
-
BAI, S.; KOLTER, J. Z.; KOLTUN, V. Deep equilibrium models. In: Advances in Neural Information Processing Systems, v. 32, 2019. ↩
-
GRAZZI, R.; FRANCESCHI, L.; PONTIL, M.; SALZO, S. On the iteration complexity of hypergradient computation. In: Proceedings of the 37th International Conference on Machine Learning. PMLR, v. 119, p. 3748–3758, 2020. ↩ ↩2
-
PEDREGOSA, F. Hyperparameter optimization with approximate gradient. In: Proceedings of the 33rd International Conference on Machine Learning. PMLR, v. 48, p. 737–746, 2016. ↩
-
AMOS, B.; KOLTER, J. Z. OptNet: differentiable optimization as a layer in neural networks. In: Proceedings of the 34th International Conference on Machine Learning. PMLR, v. 70, p. 136–145, 2017. ↩